ファイル形式をまたいで「内容が近いもの」を探せる
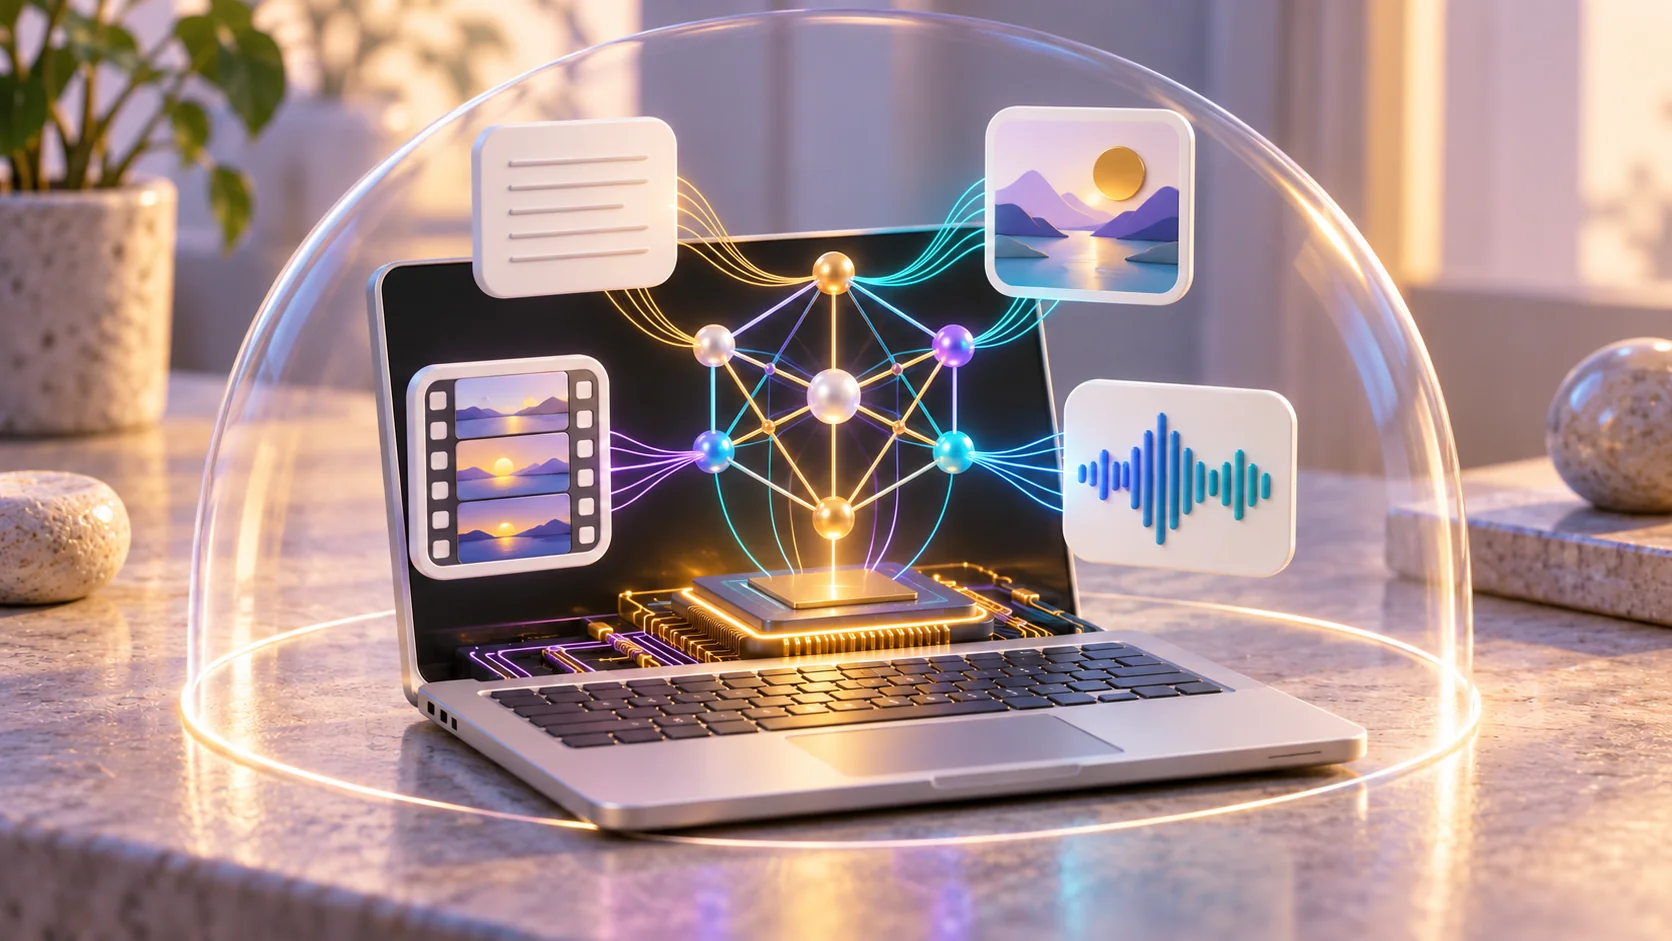
EmbeddingGemma 2は、異なる種類のデータを共通の数値表現に変換します。たとえば、文章で写真を探したり、音声を手がかりに動画の一場面を見つけたりする仕組みを組めます。資料検索の結果を生成AIに渡して回答を作るRAGにも利用できます。
GoogleはGoogle AI Edge Galleryでメディア検索や動画の場面検索のデモを提供しています。完成済みの検索アプリを一律に配る発表ではなく、開発者がこうした機能を組み込むためのモデルとツールの公開です。
文章だけなら小さく、画像や音声が必要なら追加
モデル全体は7億4,000万パラメータですが、文章とコードだけなら2億7,000万の構成で動かせます。画像・動画用と音声用の処理部分を必要に応じて読み込む設計なので、テキスト資料だけを扱うアプリに全機能を載せる必要はありません。
出力する数値の長さも768次元から512・256・128次元へ短縮でき、検索用データの保存容量を抑えられます。ただし、短くするほど検索品質との調整が必要です。Googleのモデルカードは、特に128次元では画像や音声などの精度低下を自分の用途で検証するよう求めています。
試すなら、まず扱うデータの種類を決める
モデルはApache 2.0ライセンスで提供され、Hugging FaceやKaggleから入手できます。Python向けの公式ガイドも公開済みです。導入時は、文書検索、コード検索、メディア検索のどれを作るかを決め、必要な処理部分と保存容量を選ぶのが出発点になります。
出典
この記事をシェア
MEKUNOTEをフォロー
RSSで新着記事を読むBluesky関連記事
SynthID Detectorの一般公開
Googleは10月7日、AI生成コンテンツの透かしを確認する「SynthID Detector」を一般公開した。世界各地から英語で利用でき、画像、動画、音声を調べられる。
記事を読む
GeminiのWindowsアプリが登場。Alt+Spaceですぐ呼び出せる
GoogleがWindows 10・11向けのGeminiアプリを公開しました。ショートカットから呼び出し、文章の下書きや画像生成を頼めます。
記事を読む
Nemotron 3.5 Lightningを公開。特定の作業を分担するAI向けの小型モデル
NVIDIAがNemotron 3.5 Lightningと、モデルを振り分けるNeMo Switchyardを発表しました。複数のAIに作業を分ける構成を想定しています。
記事を読む
Google CloudがGemini agentを発表 業務を継続して進めるAIエージェント
Google CloudのGemini agentが、社内情報や業務ツールを使った作業を支援します。
Gemini 3.8 Flashを発表。サイバー防御向けのCyber版も限定提供
GoogleがGemini 3.8 Flashを一般提供しました。ソフトウェア開発や複数手順の作業を重視し、Cyber版は信頼された防御担当者に提供します。
記事を読む